工業技術研究院 資訊與通訊研究所 劉治能 蔡皓名 黃姿華
為了解決大模型可能產生的幻覺,並提升技術指標的客觀性,還可進一步引入了檢索增強生成機制。
前言
前言 隨著智慧製造與工業自動化的快速發展,瑕疵檢測已成為確保產品品質與提升生產效率之關鍵技術。近年來,深度學習方法廣泛應用於影像分類、物件偵測與分割等檢測任務,但其效能高度依賴大量且具代表性的標註資料。然而在實務場域中,瑕疵樣本往往稀少且分布不均,特別是在新產品導入階段,常面臨長尾分布與資料不足問題,導致模型泛化能力受限。雖然生成式模型可用於補充訓練資料,但其生成品質與語意一致性仍缺乏有效控管機制,限制了實際應用價值。
為此,結合視覺語言模型(Vision-Language Model, VLM)與生成式模型(Generative Models)之閉環架構,是實現瑕疵檢測資料自動化優化流程的一種可行導入方案。此研究透過資料分析識別缺口,利用生成模型產生多樣化瑕疵影像,並結合視覺語言模型進行語意與品質篩選,同時引入難例回饋機制持續優化模型與資料分布。以此自我強化閉環架構降低人工標註成本,並有效提升模型在少樣本與長尾情境下的檢測效能與泛化能力。
精彩內容
1.代理式AI閉環學習
2. 瑕疵生成自動優化
3.視覺語言模型智慧資料篩選 |
視覺語言模型與生成式資料相關研究與背景
隨著深度學習技術於工業視覺檢測領域的發展,基於卷積神經網路(Convolutional Neural Network, CNN)[1]與Vision Transformer(ViT)[2]的瑕疵檢測模型,已被廣泛應用於半導體、電子製造與光學元件等場域。然而,工業瑕疵資料通常具有樣本稀少、類別不均等種種特性,特別是在新產品導入階段或是在少量多樣的生產型態中,往往缺乏足夠的瑕疵樣本讓模型訓練與學習,導致模型泛化能力受限。因此,如何有效擴增瑕疵資料並提升模型對少樣本瑕疵的辨識能力,一直都是工業AI領域的重要研究方向。
為解決工業瑕疵檢測領域資料不足的問題,導入生成式模型被認為是一個具體有效的方案,部分研究亦已證實[3],利用生成資料擴增可有效提升分類與檢測模型之辨識效能。早期在生成影像資料的研究中,多利用生成對抗網路(Generative Adversarial Network, GAN)以進行資料擴增,以生成具特定瑕疵特徵之影像,提高模型對異常樣態的學習能力。例如,Bosquet等人即利用生成對抗網路模型,提出結合物件生成、影像修補與融合技術的完整資料擴增流程,有效提升小目標檢測效能[4]。然而,生成對抗網路類的方法普遍存在訓練不穩定與生成品質受限等問題。近年來,擴散模型(Diffusion Models)因具備較佳之生成品質與穩定性而受到廣泛關注[5, 6]。擴散模型可直接透過提示詞(Prompt)的輸入與條件控制等方式,生成出具有特定特徵與物件之影像,使生成資料更具實際應用價值[7, 8]。
另一方面,視覺語言模型之興起,也為工業檢測帶來新的可能性[9, 10]。視覺語言模型結合影像與文字語意學習能力,能透過跨模態方式理解影像內容與特徵語意。相較於傳統僅依賴視覺特徵之方法,視覺語言模型能夠利用語意資訊進行影像理解,因此逐漸被應用於零樣本分類(Zero-shot Classification)、異常檢測與影像品質評估等任務[11]。在生成資料的應用中,視覺語言模型亦被用於驗證生成影像之語意一致性與合理性,例如判斷生成的影像特徵是否符合輸入的提示詞效果。
閉環優化系統架構方法
傳統工業瑕疵檢測系統多採用開放式(Open-loop)模型建置流程,主要包含資料蒐集、人工標註、模型訓練及模型部署等步驟。以此流程完成模型訓練後,即直接應用於生產線檢測,缺乏將模型推論結果回饋至資料建置流程的機制。當產線出現新產品、新製程或未知瑕疵型態時,模型通常因訓練資料不足而導致辨識能力下降,需重新蒐集資料進行人工標註與模型訓練,不僅耗費大量人力與時間,也增加模型維護成本。此外,傳統方法多著重於模型架構設計與訓練參數調整,較少自動化的針對資料品質、資料分布及少樣本問題進行持續優化,因此難以因應工業場域中常見之資料不均及資料漂移等挑戰。
而在當代人工智慧與自動化工程的發展脈絡中,閉環優化系統(Closed-Loop Optimization System)已從傳統控制理論的反饋機制,演進為結合數據驅動、生成模型與代理型AI(Agentic AI)的動態演化架構。這種架構的核心哲學,在於將其視為一個具備「自我修正」能力的系統,而非單向執行的靜態程式。因此,為解決上述開放式架構之限制,本研究提出一套結合代理型AI、生成式AI與視覺語言模型之閉環優化架構,如圖1所示。整體流程由資料分析、生成式資料擴增、視覺語言模型品質篩選、模型訓練及模型推論等模組所組成,並透過模型推論結果持續回饋資料分析模組,形成自我優化之Closed-loop Learning。
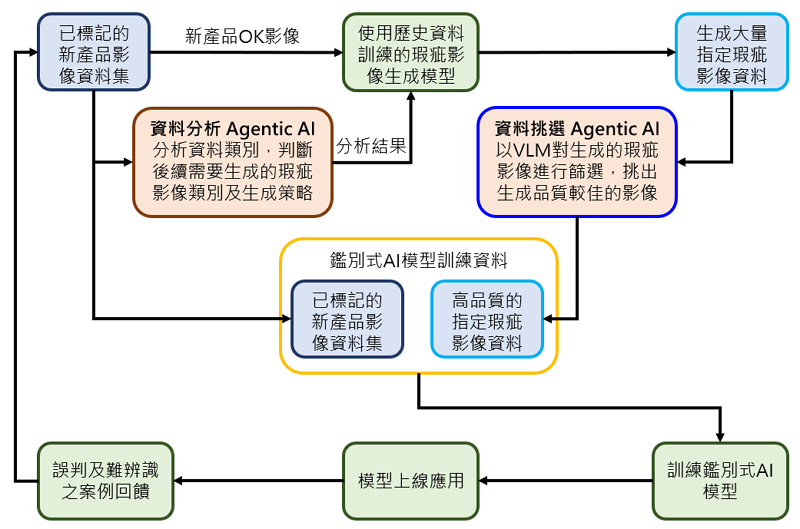
圖1 閉環優化系統架構
在工業應用或複雜決策場景中,初始資料往往伴隨著標記類別不均或瑕疵稀缺的困境。透過引入代理型AI,系統不再只是被動地接收資料,而是具備了「診斷」能力。代理型AI會分析現有資料集的弱點,識別出哪些類型的資料是當前或未來模型的知識盲區。當系統確認了知識缺口後,便進入「擴張與精煉」的循環階段。利用生成式模型,系統能針對性地生成出高品質的特定資料,補足現實中難以蒐集的瑕疵影像。然而,生成的數據若未經篩選便投入訓練,有極高的機會出現模型「退化」或引入偽特徵的風險。因此,架構中必須嵌入一個稽核的機制,如利用視覺語言模型作為自動審核員即為一個可採用的方法。視覺語言模型憑藉其廣泛的推理能力,能過濾掉不符或品質低劣的生成影像,確保進入訓練環節的生成資料具備較高的特徵一致性與品質。
與傳統開放式架構相比,本研究提出的方法具有三項特色:(1)由模型效能自動驅動資料補強,而非依賴人工經驗;(2)利用生成式AI與視覺語言模型建立自動化資料生成與品質驗證機制,降低人工標註成本;(3)建立持續學習的閉環架構,使模型能隨資料變化逐步提升泛化能力。
實驗結果與討論
我們以半導體測試場域的自動光學檢測(Automated Optical Inspection, AOI)應用情境,建構並驗證瑕疵檢測閉環優化架構。結合新產品與歷史瑕疵影像,證實上述的架構流程之可行性。
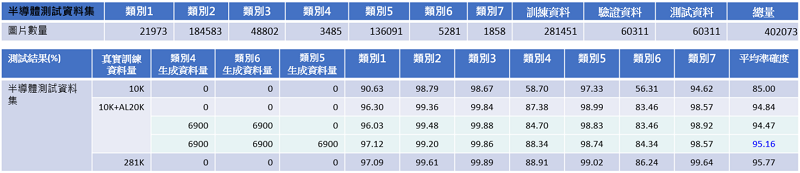
在此階段,系統將針對多瑕疵資料集中絕對數量相對稀少的類別,評估是否啟動瑕疵生成機制。實務上,若特定類別的影像特徵極為顯著,即使樣本數量稀少,亦不必然構成模型的辨識弱點。因此,本架構採取雙軌評估策略:除了考量資料分布外,亦同步觀測初始模型在各瑕疵類別的準確度表現(例如 Precision、Recall等指標),精準鎖定預測表現不佳的類別判定為實質數據弱點。
實驗數據顯示,如下表1,以此雙軌評估策略下,半導體測試資料集的「類別4」(3,485筆)、「類別6」(5,281筆)和「類別7」(1,858筆)在絕對數量上最為稀少。但觀察10K真實資料訓練的初始模型表現,可發現在類別4和類別6的準確度分別僅有58.70%與56.31%,顯著低於其他類別,因而被精準判定為核心的「資料弱點」。在結合主動式學習(Active Learning, AL)機制,以及針對此資料弱點實施生成擴增動態注入類別4與類別6的生成資料後(各加入6,900筆),該兩類的準確度大幅攀升至88.34%與84.34%。這使得平均準確度從初始的85.00%提升至95.16%,其表現已極度逼近使用281K真實資料訓練的成果(95.77%)。
表1 半導體檢測影像資料集與實驗結果
在瑕疵影像生成策略上,本階段主要基於擴散模型進行微調,並針對瑕疵的特性運用多種生成手法來落實。整個流程從瑕疵特徵的擷取開始,首先將真實瑕疵影像給予精準的標記文本描述,產生用於擴散模型的訓練資料。隨後,利用這些描述與影像的配對,針對各特定的瑕疵類別訓練出專屬的影像生成模型。在生成具體缺陷時,為了確保擴增影像與真實影像具備製程一致性,系統會引入真實的無瑕疵影像作為目標背景,將特定瑕疵精準地生成到正常的無瑕疵影像內。下圖1即為前述半導體檢測影像資料集實驗中,類別4和類別6生成的影像效果。如前所述,類別4和類別6原始資料集中屬於少樣本類別,且模型辨識率較低,因此本文選擇此兩類作為生成式資料擴增之驗證對象。
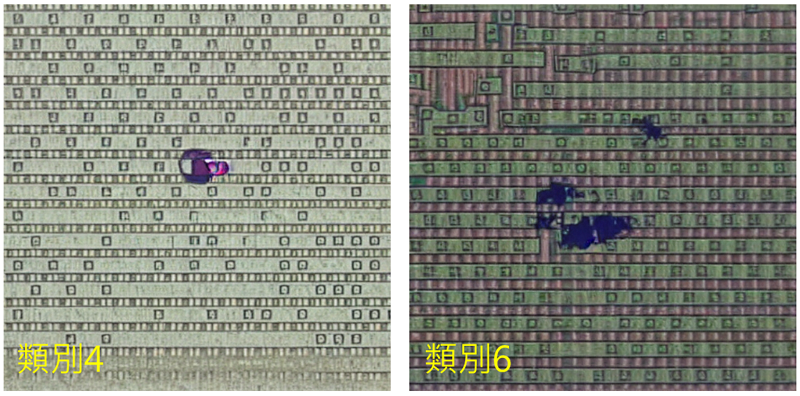
圖2 半導體測試場域瑕疵影像生成效果
生成完畢後,為確保生成模型批量產出的生成影像不會變成誤導模型的無效樣本,視覺語言模型可用於建立一套嚴密的資料篩選機制。執行的方式在於建構產線專屬的「視覺大腦」:透過使用大量歷史瑕疵影像與標記文本進行深度微調,取得一個領域適用的專用視覺語言模型,讓模型具備半導體瑕疵辨識與語意理解能力。為了解決大模型可能產生的幻覺,並提升技術指標的客觀性,還可進一步引入了檢索增強生成(Retrieval-Augmented Generation, RAG)機制,讓視覺語言模型在審查新生成的瑕疵影像時,從知識庫中檢索出相似的歷史瑕疵案例作為參考資料。
在審查流程中,系統會執行嚴格的語意一致性檢查,將最初引導生成的文字提示詞與最終產出的影像進行反向比對,評估視覺特徵與原始語意是否吻合,藉此剔除圖文不符的失效樣本。隨後,視覺語言模型會確認生成的影像瑕疵特徵與型態,以防範「標記錯誤」或類別汙染的發生,確保只有具備高代表性與實用價值的影像才能進入訓練集。
結論
本研究提出一套結合視覺語言模型、生成式資料擴增與代理型AI閉環學習之工業瑕疵檢測架構,可針對少樣本與長尾分布問題,自動完成資料分析、瑕疵生成、品質篩選及模型優化。相較於傳統依賴人工蒐集與標註資料之方式,本研究提供一種以資料為核心的自動化模型建置流程,有效降低資料建置成本並提升模型泛化能力。
以半導體AOI檢測為驗證場域的實驗結果顯示,透過生成式資料補強與視覺語言模型篩選機制,可有效改善少樣本類別之辨識能力,使整體模型準確率由85.00%提升至95.16%。此結果證明生成式AI不僅可作為資料擴增工具,更可結合視覺語言模型形成具自主優化能力之閉環架構。
本研究並非提出新的瑕疵檢測模型,而是建立一套可持續優化資料品質之代理型AI閉環架構,提供工業AI由Model-Centric轉向Data-Centric的重要實踐方向。未來亦可延伸至印刷電路板(Printed Circuit Board, PCB)、光學檢測、金屬表面及醫療影像等其他視覺檢測領域,並進一步結合多代理型AI(Multi-Agent AI)協作及持續學習機制,建構更具自主性的智慧檢測系統。
參考文獻
[1] A. Krizhevsky, I. Sutskever, and G. E. Hinton, "ImageNet Classification with Deep Convolutional Neural Networks," in: Proceedings of the 26th Annual Conference on Neural Information Processing Systems (NeurIPS), Lake Tahoe, NV, USA, 2012, pp. 1097–1105.
[2] A. Dosovitskiy, L. Beyer, A. Kolesnikov, D. Weissenborn, X. Zhai, T. Unterthiner, M. Dehghani, M. Minderer, G. Heigold, S. Gelly, J. Uszkoreit, and N. Houlsby, "An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale," in: Proceedings of the International Conference on Learning Representations (ICLR), Virtual Event, 2021.
[3] G. Valvano, A. Agostino, G. De Magistris, A. Graziano, and G. Veneri, "Controllable Image Synthesis of Industrial Data Using Stable Diffusion," in: Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV), Waikoloa, HI, USA, 2024, pp. 5354–5363.
[4] B. Bosquet, D. Cores, L. Seidenari, V. M. Brea, M. Mucientes, and A. Del Bimbo, "A Full Data Augmentation Pipeline for Small Object Detection Based on Generative Adversarial Networks," Pattern Recognition, vol. 133, Art. no. 108998, 2023.
[5] J. Ho, A. Jain, and P. Abbeel, "Denoising Diffusion Probabilistic Models," in: Proceedings of the 34th Annual Conference on Neural Information Processing Systems (NeurIPS), Virtual Event, 2020.
[6] R. Rombach, A. Blattmann, D. Lorenz, P. Esser, and B. Ommer, "High-Resolution Image Synthesis with Latent Diffusion Models," in: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), New Orleans, LA, USA, 2022, pp. 10684–10695.
[7] L. Zhang and M. Agrawala, "Adding Conditional Control to Text-to-Image Diffusion Models," in: Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV), Paris, France, 2023, pp. 3836–3847.
[8] N. Ruiz, Y. Li, V. Jampani, Y. Pritch, M. Rubinstein, and K. Aberman, "DreamBooth: Fine Tuning Text-to-Image Diffusion Models for Subject-Driven Generation," in: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), Vancouver, BC, Canada, 2023, pp. 22500–22510.
[9] A. Radford, J. W. Kim, C. Hallacy, A. Ramesh, G. Goh, S. Agarwal, G. Sastry, A. Askell, P. Mishkin, J. Clark, G. Krueger, and I. Sutskever, "Learning Transferable Visual Models From Natural Language Supervision," in: Proceedings of the 38th International Conference on Machine Learning (ICML), Virtual Event, 2021, pp. 8748–8763.
[10] H. Liu, C. Li, Q. Wu, and Y. J. Lee, "Visual Instruction Tuning," in: Proceedings of the 37th Annual Conference on Neural Information Processing Systems (NeurIPS), New Orleans, LA, USA, 2023.
[11] H. Wang, C. Li, and Y. Lin, "Large-Scale Visual Language Model Boosted by Contrast Domain Adaptation for Intelligent Industrial Visual Monitoring," IEEE Transactions on Industrial Informatics, vol. 20, no. 12, pp. 14114–14123, 2024.

